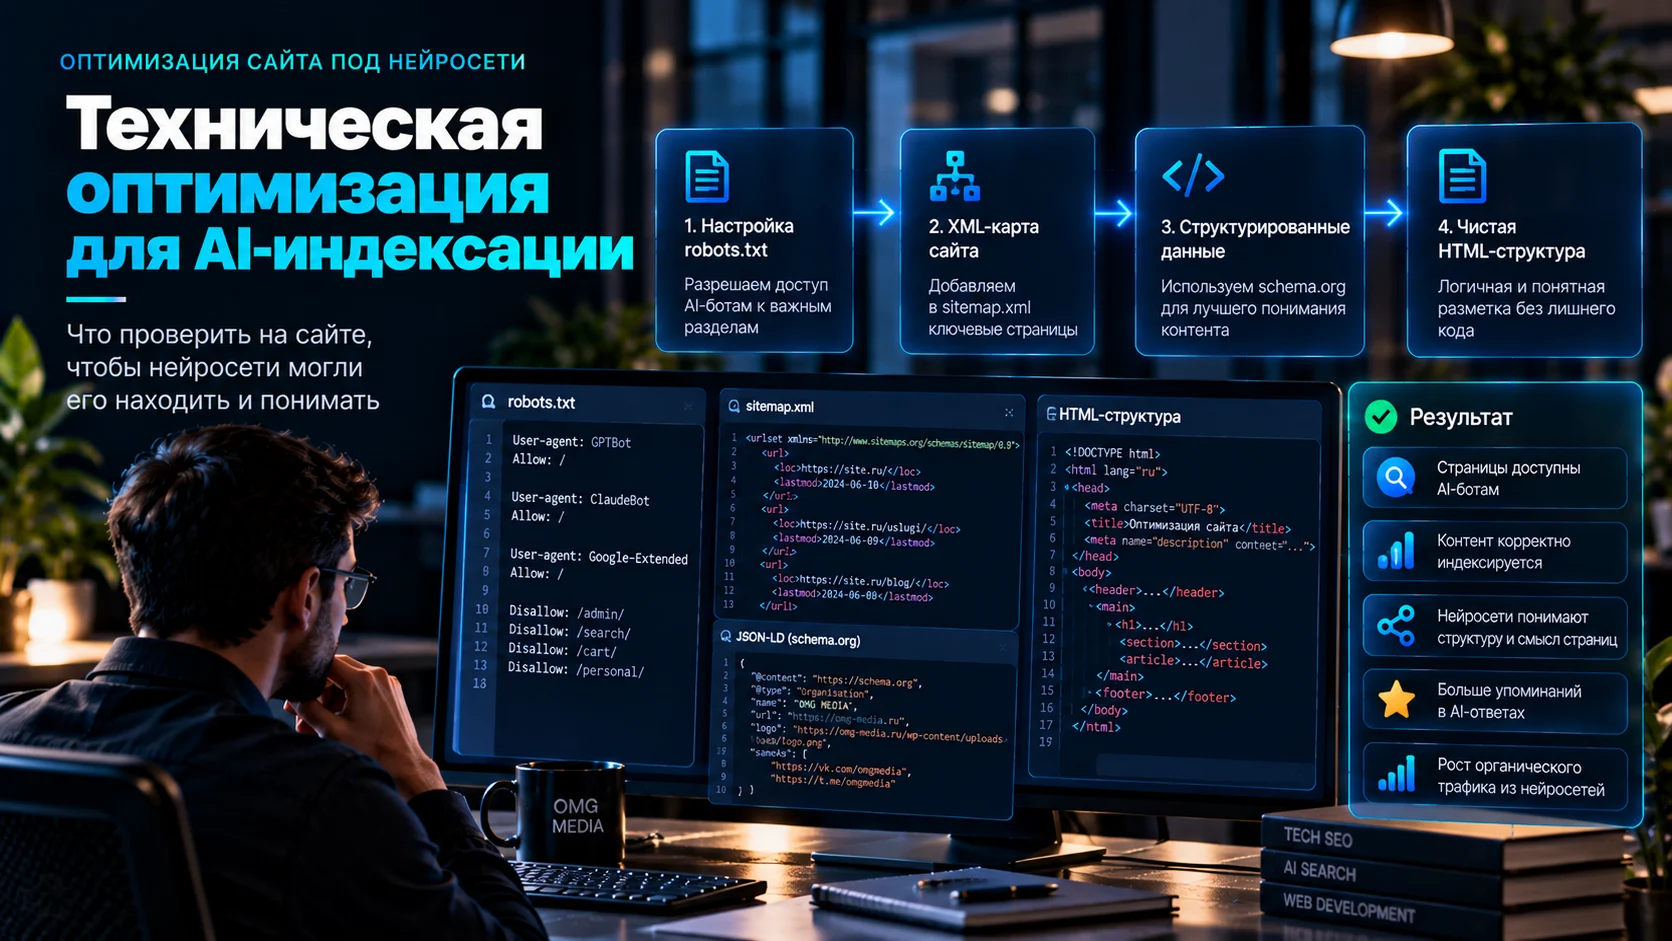
Оптимизация сайта под нейросети — это не набор «секретных» тегов для ChatGPT, а системная проверка того, может ли поисковая или AI-система обнаружить страницу, получить её содержимое, корректно проиндексировать и понять, какой факт, сущность или ответ на ней заслуживает использования как источник. На практике работа начинается с crawlability, indexability и рендеринга, а заканчивается качеством доказательств, внутренними связями, актуальностью и измерением AI visibility.
Эта статья посвящена именно устройству и содержанию сайта. Более широкий вопрос — как устроены AEO/GEO, как формируется тематическая видимость и как планировать продвижение — разобран отдельно в материале «Продвижение сайта в нейросетях: как попасть в ответы ИИ-поиска».
Коротко: что нужно оптимизировать
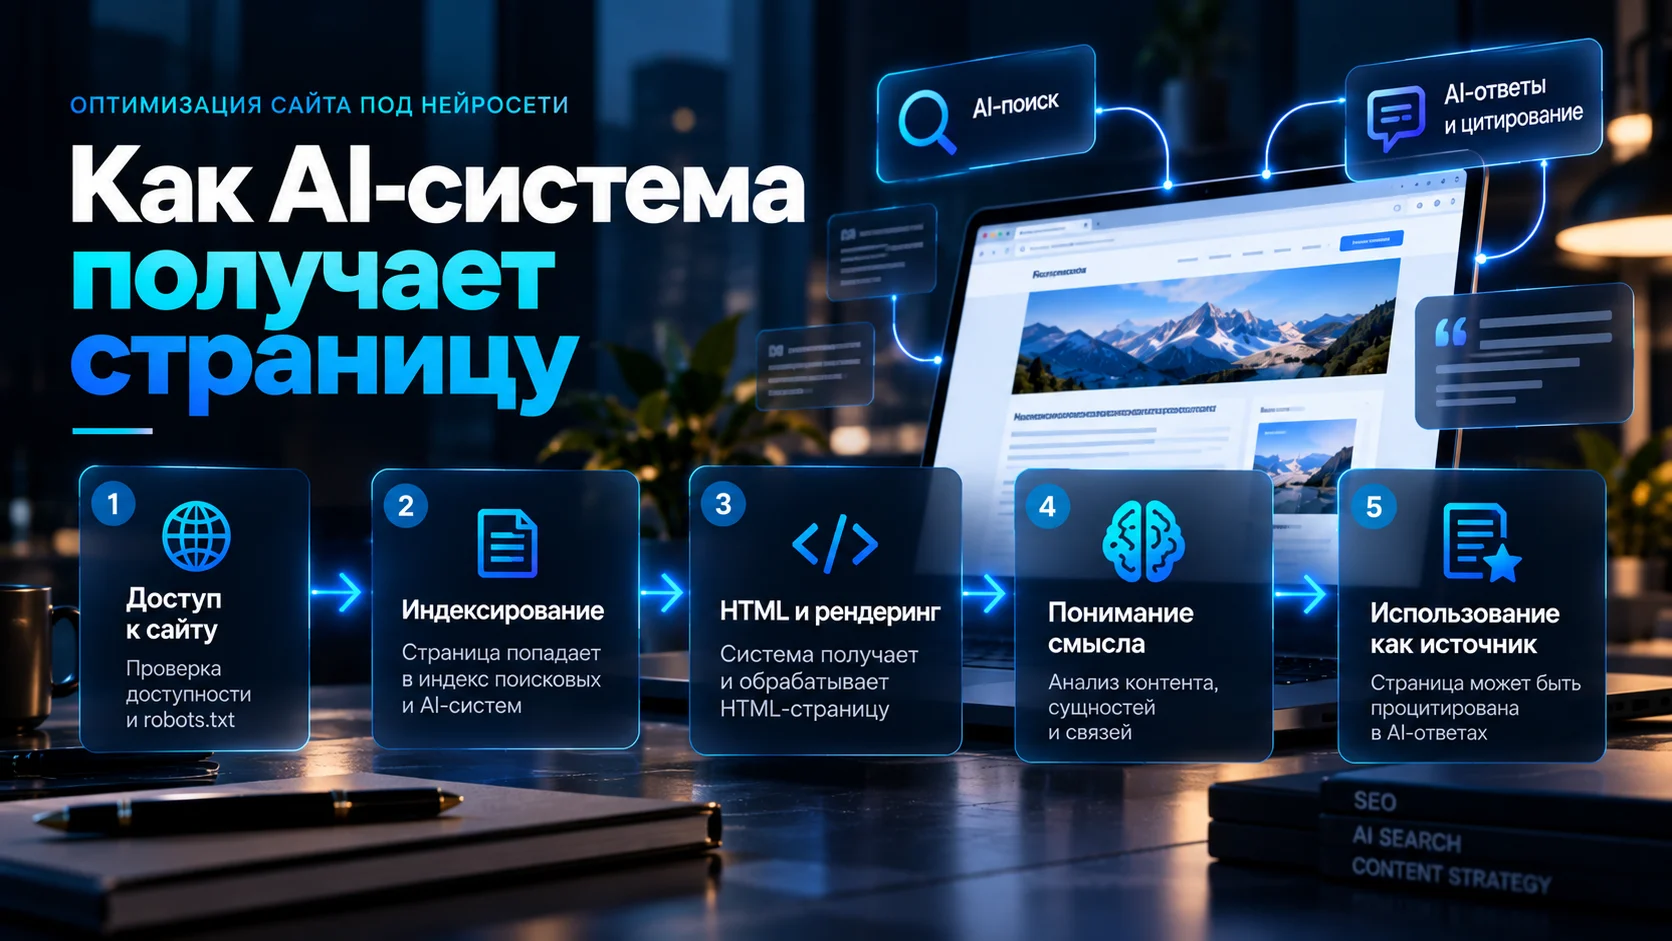
У сайта нет переключателя «цитировать в нейросетях». Нужно последовательно убрать технические препятствия, сделать важный контент доступным в HTML, однозначно описать сущности, давать самостоятельные прямые ответы, подтверждать утверждения источниками и опытом, связывать страницы в понятную тематическую структуру и регулярно проверять, где бренд и URL реально появляются в AI-ответах.
Гарантированного способа заставить ChatGPT цитировать сайт не существует. OpenAI указывает, что для доступности в ChatGPT Search важно разрешить OAI-SearchBot и не блокировать опубликованные IP-диапазоны на уровне хостинга или CDN, но верхнее размещение гарантировать нельзя. Точно так же соблюдение рекомендаций Google или Bing повышает техническую пригодность и видимость, но не гарантирует обход, индексирование, показ или цитирование.
1. Проверьте crawlability: кто и зачем может получить страницу
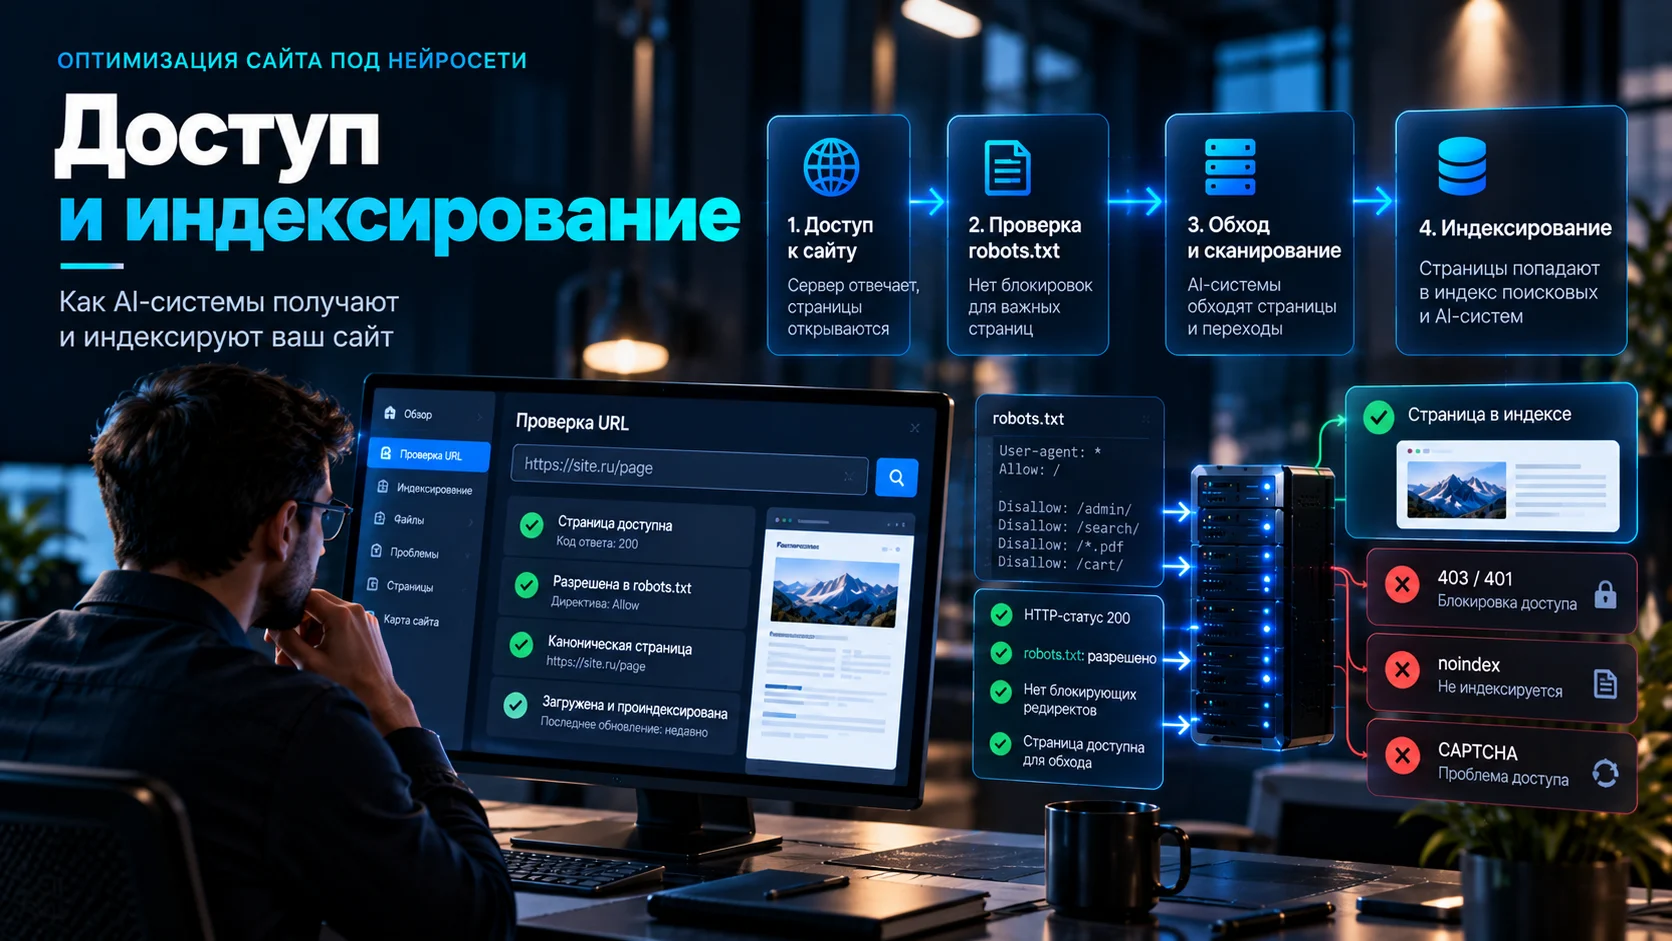
Первый вопрос аудита — не «открыты ли все AI-боты», а какая система нужна бизнесу и для какой функции нужен конкретный робот. Поиск, пользовательский fetch и сбор данных для обучения моделей — разные сценарии. Блокировка training-бота не всегда означает отказ от AI-поиска, а разрешение training-бота само по себе не даёт поисковой видимости.
| Система | Что важно для поиска/ответов | Что не стоит смешивать с поиском | Что проверить |
|---|---|---|---|
| Google Search | Googlebot и обычная поисковая доступность | Google-Extended управляет использованием контента в некоторых других AI-системах Google, но не доступом к AI Overviews и AI Mode в Поиске | robots.txt, CDN/WAF, ресурсы рендеринга, индексирование |
| ChatGPT Search | OAI-SearchBot | GPTBot относится к возможному обучению моделей и управляется отдельно | robots.txt, WAF/CDN, опубликованные IP-диапазоны, логи |
| Claude | Claude-SearchBot для поиска; Claude-User для запросов, инициированных пользователем | ClaudeBot используется для сбора данных, которые могут применяться при обучении моделей | отдельные правила robots.txt для нужных ролей |
| Perplexity | PerplexityBot для поиска; Perplexity-User для запросов пользователя | PerplexityBot, по документации сервиса, не предназначен для обучения foundation-моделей | robots.txt для PerplexityBot, WAF и официальные IP-диапазоны |
| Яндекс и Алиса AI | страница должна быть проиндексирована Яндексом; YandexAdditional/YandexAdditionalBot используются как контроль исключения контента из AI-ответов | эти обозначения не заменяют обычное индексирование Яндексом | доступ основного робота, индекс, отсутствие случайного запрета YandexAdditional |
Что проверить кроме robots.txt
- Возвращает ли URL нормальный ответ без авторизации, CAPTCHA и межстраничного challenge.
- Не режет ли CDN или WAF поискового робота по User-Agent, IP, географии или rate limit.
- Доступны ли CSS и JavaScript, если без них невозможно получить основной текст или структуру.
- Не закрыт ли нужный раздел общим правилом для группы user-agent.
- Совпадает ли реальный ответ сервера с тем, что ожидается по robots.txt: это видно по логам и тестовым запросам.
Практический вывод: политика доступа должна быть осознанной. Можно разрешать поисковые и пользовательские роботы, одновременно отдельно ограничивая сбор данных для обучения, если это соответствует политике компании.
2. Проверьте indexability: доступный URL ещё не значит индексируемый
После обхода нужно проверить, может ли поисковая система включить страницу в индекс и использовать её как результат. Для Google это особенно важно: чтобы URL мог стать поддерживающей ссылкой в AI Overviews или AI Mode, он должен быть проиндексирован и пригоден для показа в Google Search со сниппетом.
- HTTP-статус. Важная страница должна стабильно отдавать ожидаемый успешный ответ, а не soft 404, цепочку редиректов или периодические 5xx.
- Canonical. Канонический URL должен соответствовать той версии страницы, которую вы хотите видеть в поиске и AI-источниках.
- Noindex. Случайный noindex исключает страницу из индекса. При этом робот должен иметь возможность получить страницу, чтобы увидеть метадирективу.
- Snippet controls. nosnippet, data-nosnippet и max-snippet могут ограничивать отображение и использование фрагментов в поисковых AI-функциях. Их нельзя ставить массово, не понимая последствий.
- Дубли. Параметры, печатные версии, фильтры и несколько URL одного материала размывают выбор канонической страницы и усложняют обновление.
- Sitemap и внутренние ссылки. В карту сайта должны попадать актуальные канонические URL, а важные страницы должны находиться через обычные внутренние ссылки.
Если задача шире AI-доступности и нужно проверить статусы, зеркала, canonical, sitemap, дубли, мобильную версию и другие базовые элементы, используйте отдельный чек-лист SEO-аудита сайта. Здесь эти проверки рассматриваются только как фундамент доступности источника для search/AI-систем.
3. Проверьте рендеринг: основной смысл не должен зависеть от действий пользователя
Google умеет выполнять JavaScript, но сам процесс включает отдельные этапы обхода, рендеринга и индексирования. Другие системы используют собственные способы загрузки страниц. Поэтому безопасная инженерная цель — не «отказаться от JavaScript», а добиться того, чтобы критически важный смысл страницы был стабильно доступен без сложного клиентского сценария.
- Сравните исходный ответ сервера и отрендеренный DOM: есть ли в нём заголовок, основной текст, цены, характеристики, FAQ и ссылки, которые нужны для понимания страницы.
- Не прячьте единственный экземпляр важной информации за кликом, прокруткой, бесконечной подгрузкой или формой.
- Используйте обычные HTML-ссылки с атрибутом href для маршрутов, которые должны обнаруживаться роботом.
- Для SPA убедитесь, что значимые экраны имеют устойчивые URL и не превращаются для робота в одинаковую пустую оболочку.
- Если SSR, SSG или пререндеринг делают критический контент доступнее и стабильнее, это разумное снижение риска, но не обязательная технология для каждого проекта.
Не стоит отдавать роботам содержательно другую страницу только ради AI-оптимизации. Такая практика создаёт риск cloaking и делает диагностику сложнее.
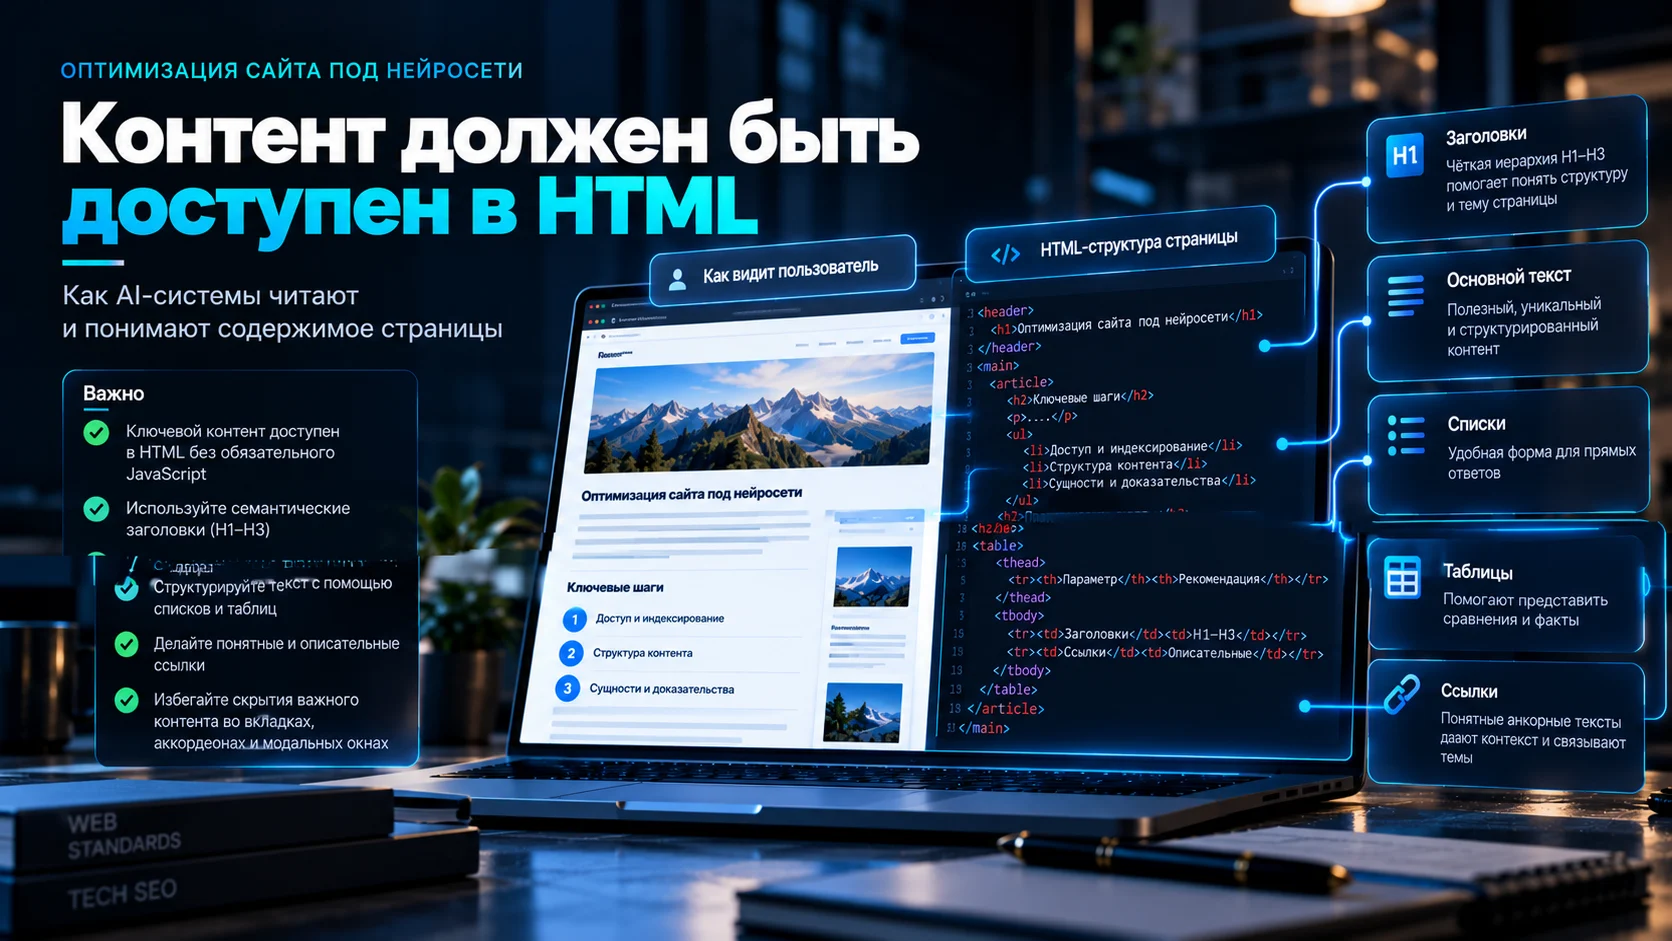
4. Сделайте HTML понятным как документ
«Машиночитаемость» начинается не со сложного JSON-LD, а с нормального документа. Заголовки должны отражать реальную иерархию, абзацы — содержать законченную мысль, а таблицы и списки — использоваться там, где они действительно упрощают сравнение или последовательность действий.
- Один основной заголовок страницы и логичная структура H2/H3 без скачков ради дизайна.
- Понятный title страницы, который соответствует интенту.
- Основной текст — как текст, а не только изображение, canvas или подпись внутри интерфейса.
- Семантически понятные элементы main, article и section там, где они естественны для шаблона.
- Таблицы — для сравнения, списки — для шагов и проверок, абзацы — для объяснения.
- Важные факты не должны существовать только в tooltip, модальном окне или после запроса к закрытому API.
Идеальный HTML не является отдельным «фактором цитирования». Цель — снизить неоднозначность и сделать содержание доступным пользователю, поисковому роботу и системам извлечения.
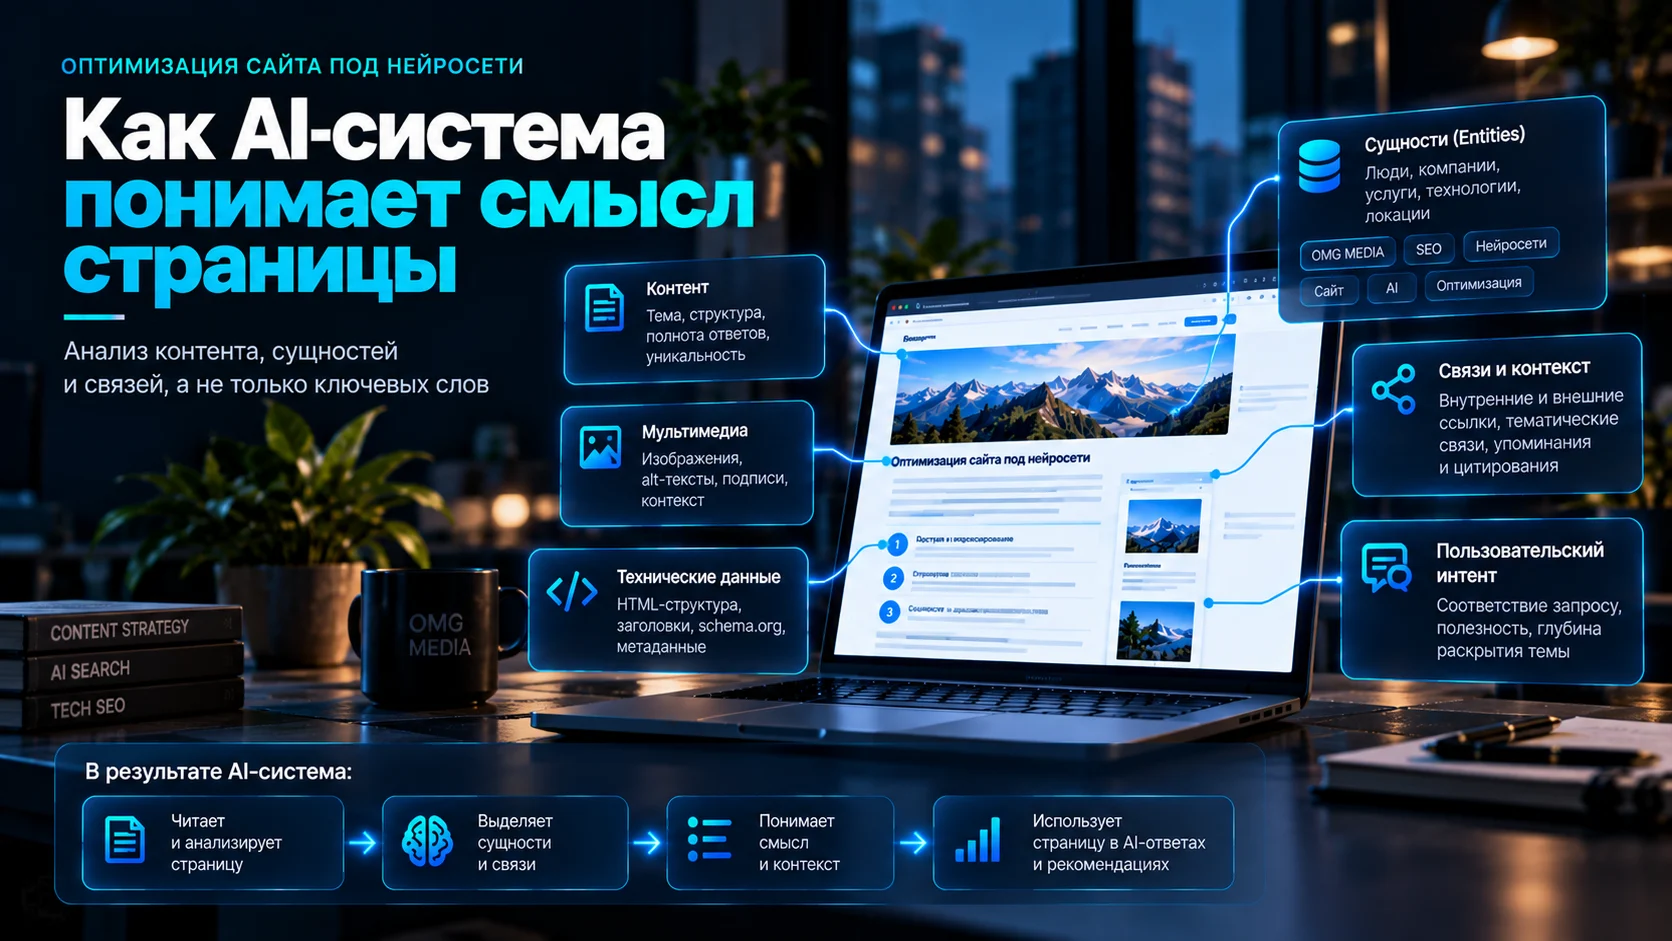
5. Опишите сущности и используйте schema без магического мышления
Сущность — это конкретный объект: организация, человек, услуга, продукт, место, статья. Чем меньше противоречий между названием, автором, контактами, страницами профиля и структурированными данными, тем проще системе сопоставить упоминания.
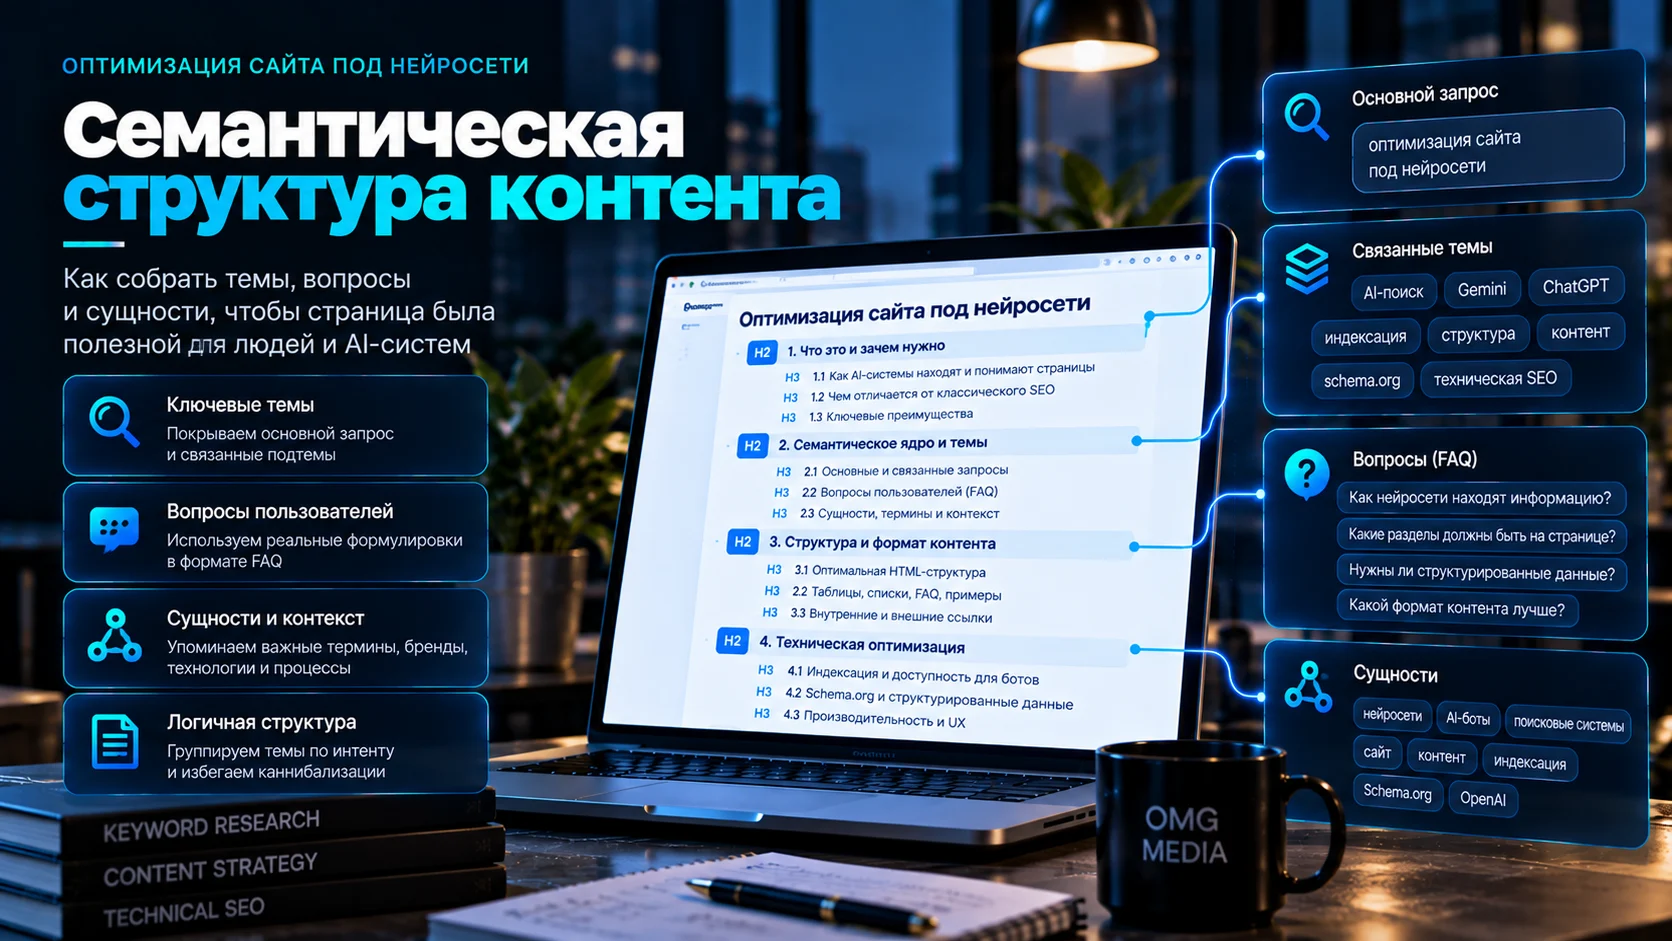
Что имеет смысл разметить
- Organization — данные об организации на главной или странице о компании, если они соответствуют видимому содержанию.
- Article/BlogPosting — название материала, автор, даты публикации и обновления, если CMS и шаблон поддерживают корректную разметку.
- Person — автор или эксперт, когда есть реальная страница профиля с проверяемой биографией.
- BreadcrumbList — структура навигации, если хлебные крошки есть на сайте.
- Service/Product — на соответствующих коммерческих страницах, когда свойства отражают фактическое предложение.
Schema помогает явно описывать данные, но не является кнопкой «цитировать». Google прямо указывает, что для AI Overviews и AI Mode не нужна специальная schema.org-разметка, а структурированные данные должны совпадать с видимым текстом. Даже валидная разметка не гарантирует отдельный поисковый или AI-результат.
FAQ-блок может быть полезен читателю, но не стоит добавлять FAQPage только ради ожидания AI-эффекта. В мае 2026 года Google прекратил показ FAQ rich results в поиске; сам формат вопросов и ответов по-прежнему может быть удобен как контент, но это не аргумент для обязательной микроразметки.
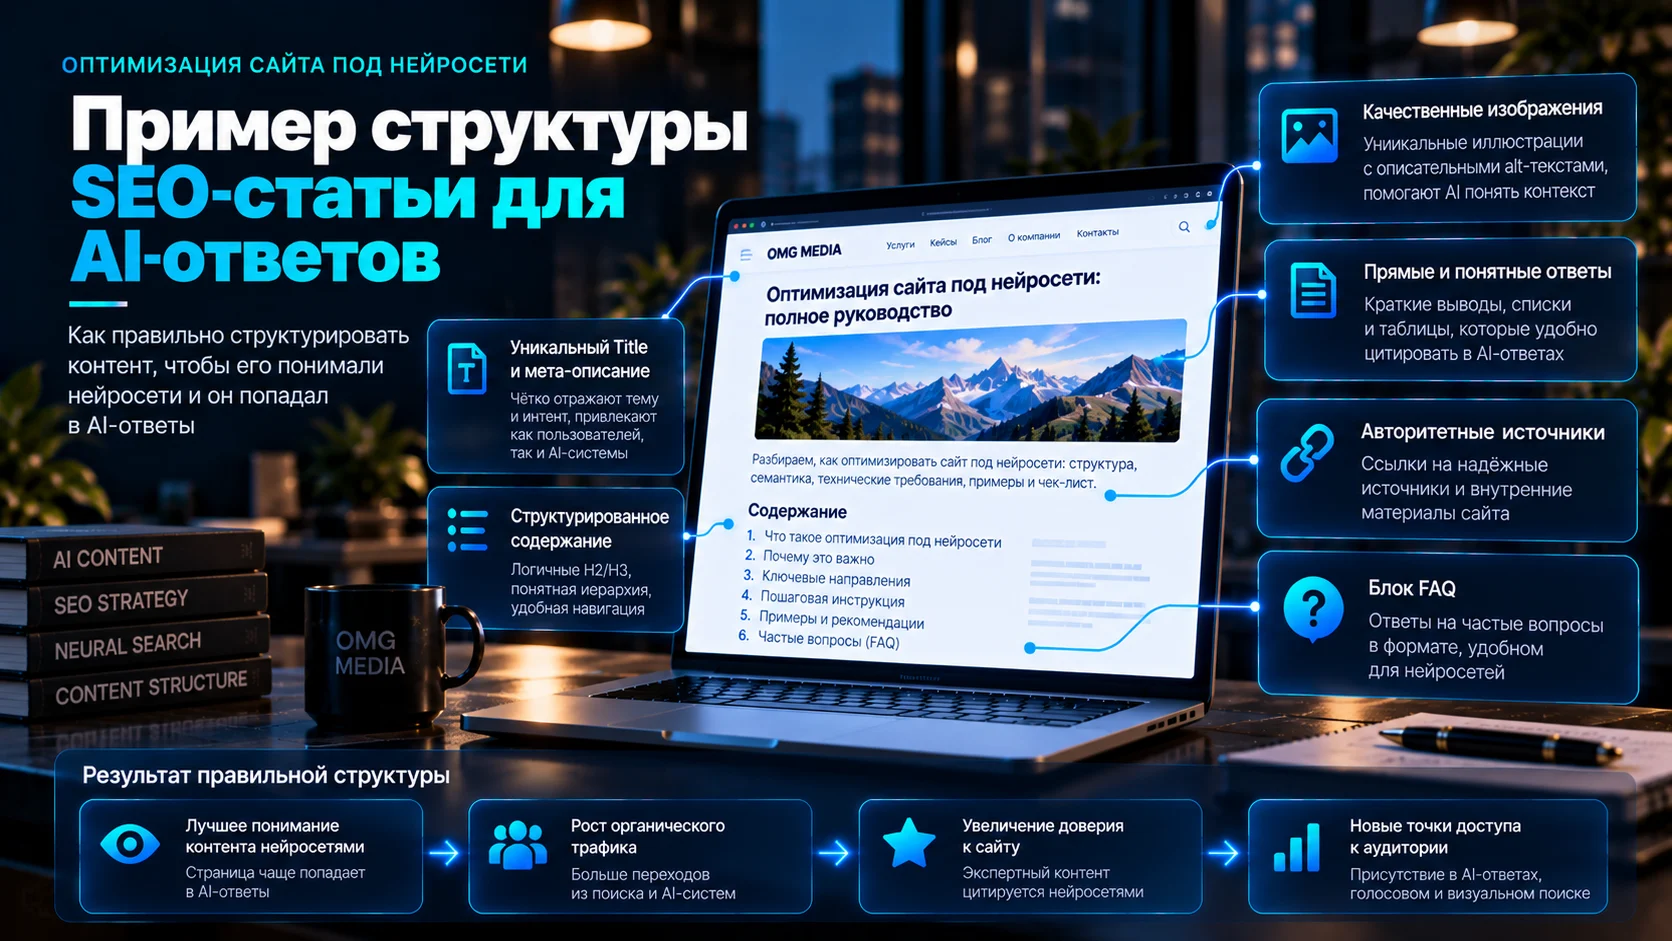
6. Стройте контент из прямых, самостоятельных ответов
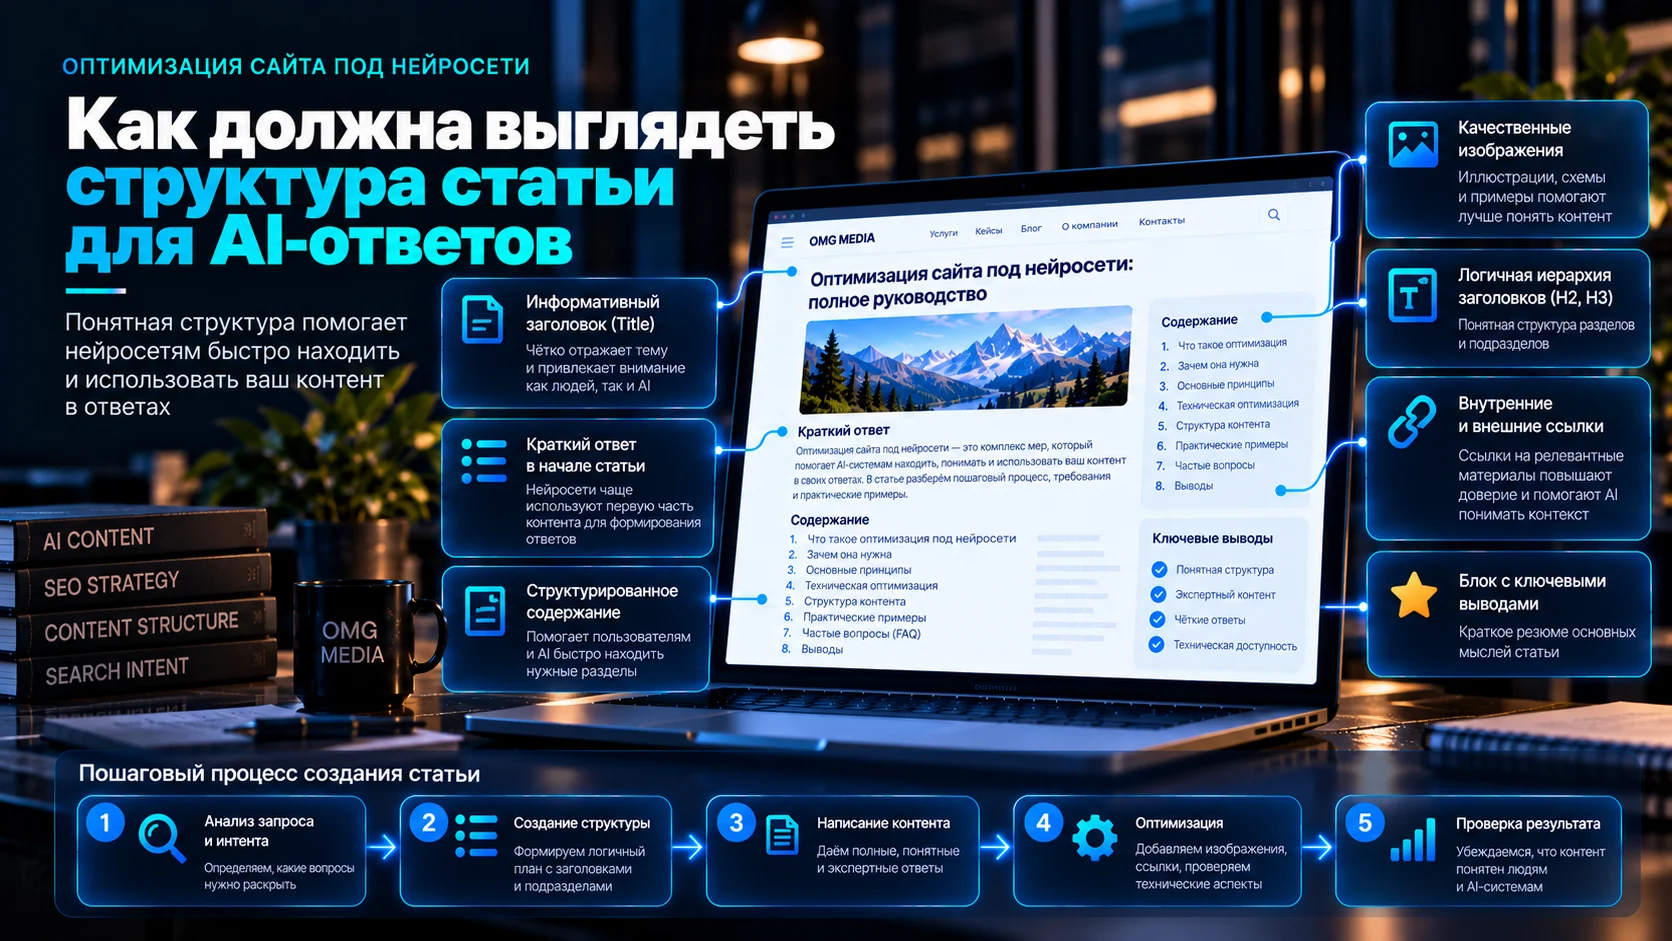
Для цитируемости полезен не «текст для LLM», а фрагмент, который можно понять без восстановления смысла из пяти предыдущих абзацев. Начинайте раздел с вывода, если читателю действительно нужен вывод, а затем объясняйте условия, исключения и доказательства.
Рабочая модель блока
- Вопрос или тезис. Заголовок обозначает конкретную задачу.
- Прямой ответ. Первые предложения дают самостоятельный вывод без рекламной преамбулы.
- Условия. Что должно быть верно, чтобы ответ применялся.
- Доказательство. Первичный источник, данные, кейс, пример или метод проверки.
- Следующий шаг. Что проверить или сделать после чтения.
Не существует доказанного универсального правила «ответ должен быть ровно 40–60 слов» или «каждый H2 обязан начинаться с определения». Длина и форма должны следовать задаче. Короткий ответ хорош, когда вопрос короткий; сложное решение требует контекста и ограничений.
7. Добавьте источники, авторство и доказательства
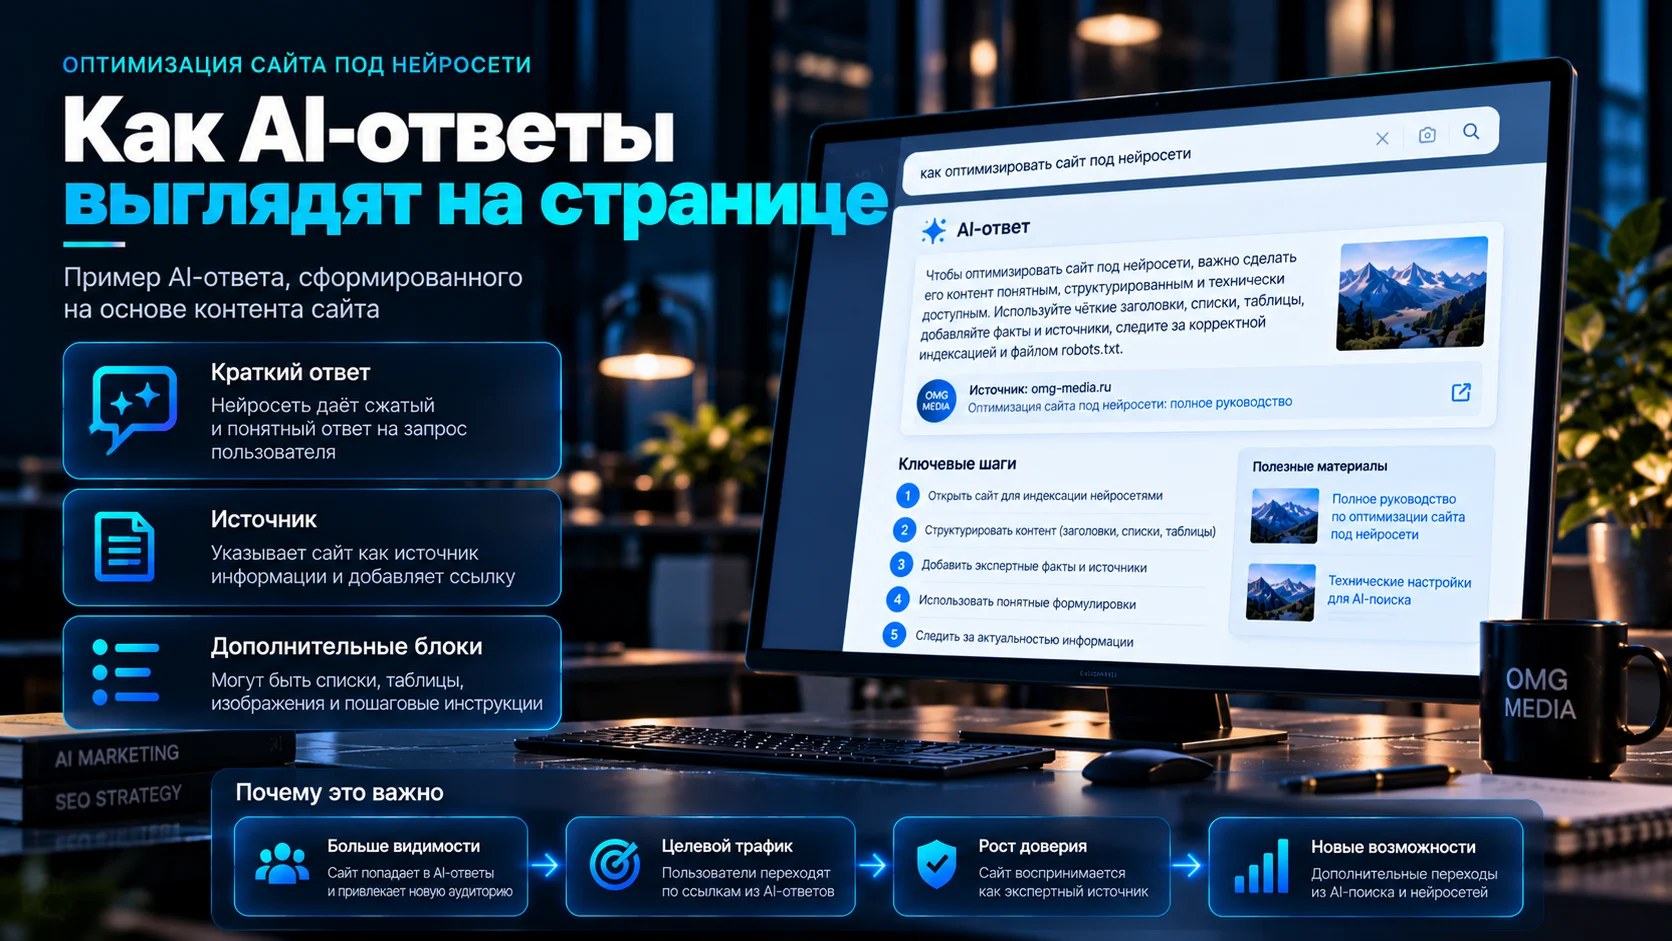
Источник ценнее пересказа, когда пользователь или система может проверить утверждение. Для технических рекомендаций приоритетны документы самой платформы; для исследования — методология и исходные данные; для кейса — условия, период, действия и измеримый результат.
- Указывайте автора или редакцию там, где читателю важно понимать ответственность за материал.
- Связывайте имя автора со страницей, где описаны опыт и компетенции, а не только должность.
- Для изменчивых фактов указывайте дату проверки и ссылку на первичный источник.
- Отделяйте подтверждённый факт от гипотезы, наблюдения и редакционного вывода.
- Не публикуйте выдуманные проценты роста AI visibility, «успешные кейсы» без исходных условий и неподтверждённые факторы ранжирования.
- Если цифра рассчитана внутри компании, опишите метод расчёта и ограничения.
Google в рекомендациях по people-first content отдельно предлагает показывать, кто создал материал, на чём основана экспертиза и какие источники или доказательства позволяют доверять содержанию. Для AI-видимости это полезно не как отдельный гарантированный фактор, а как способ сделать материал проверяемым и самостоятельным.
8. Свяжите страницу с тематическим контуром и брендом
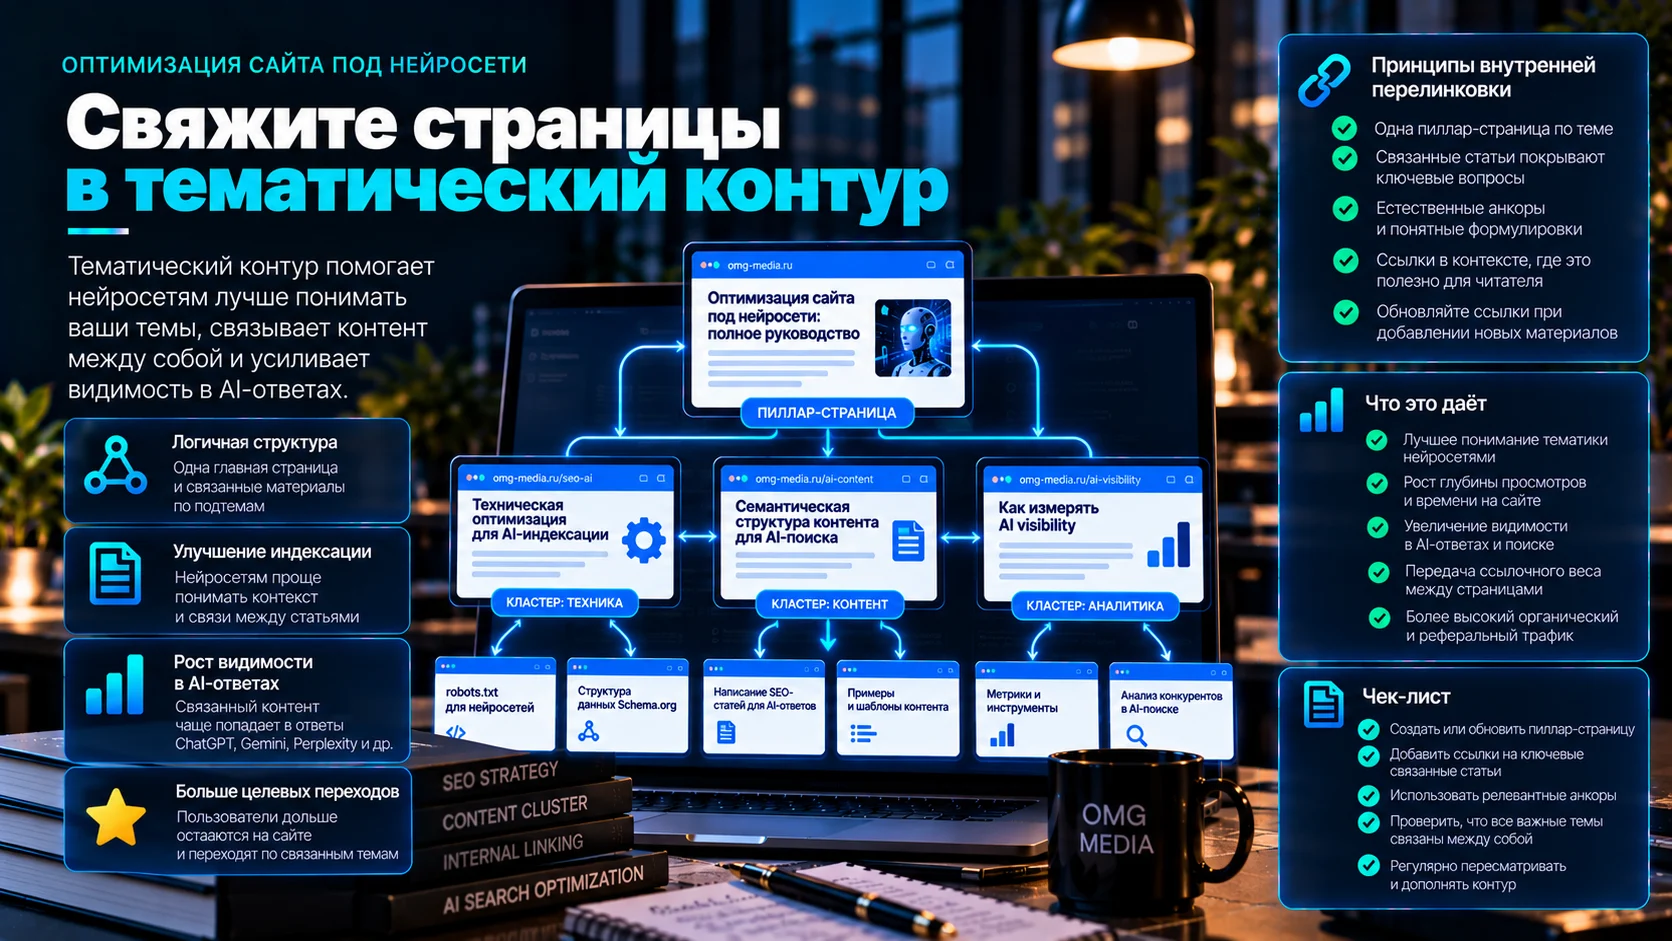
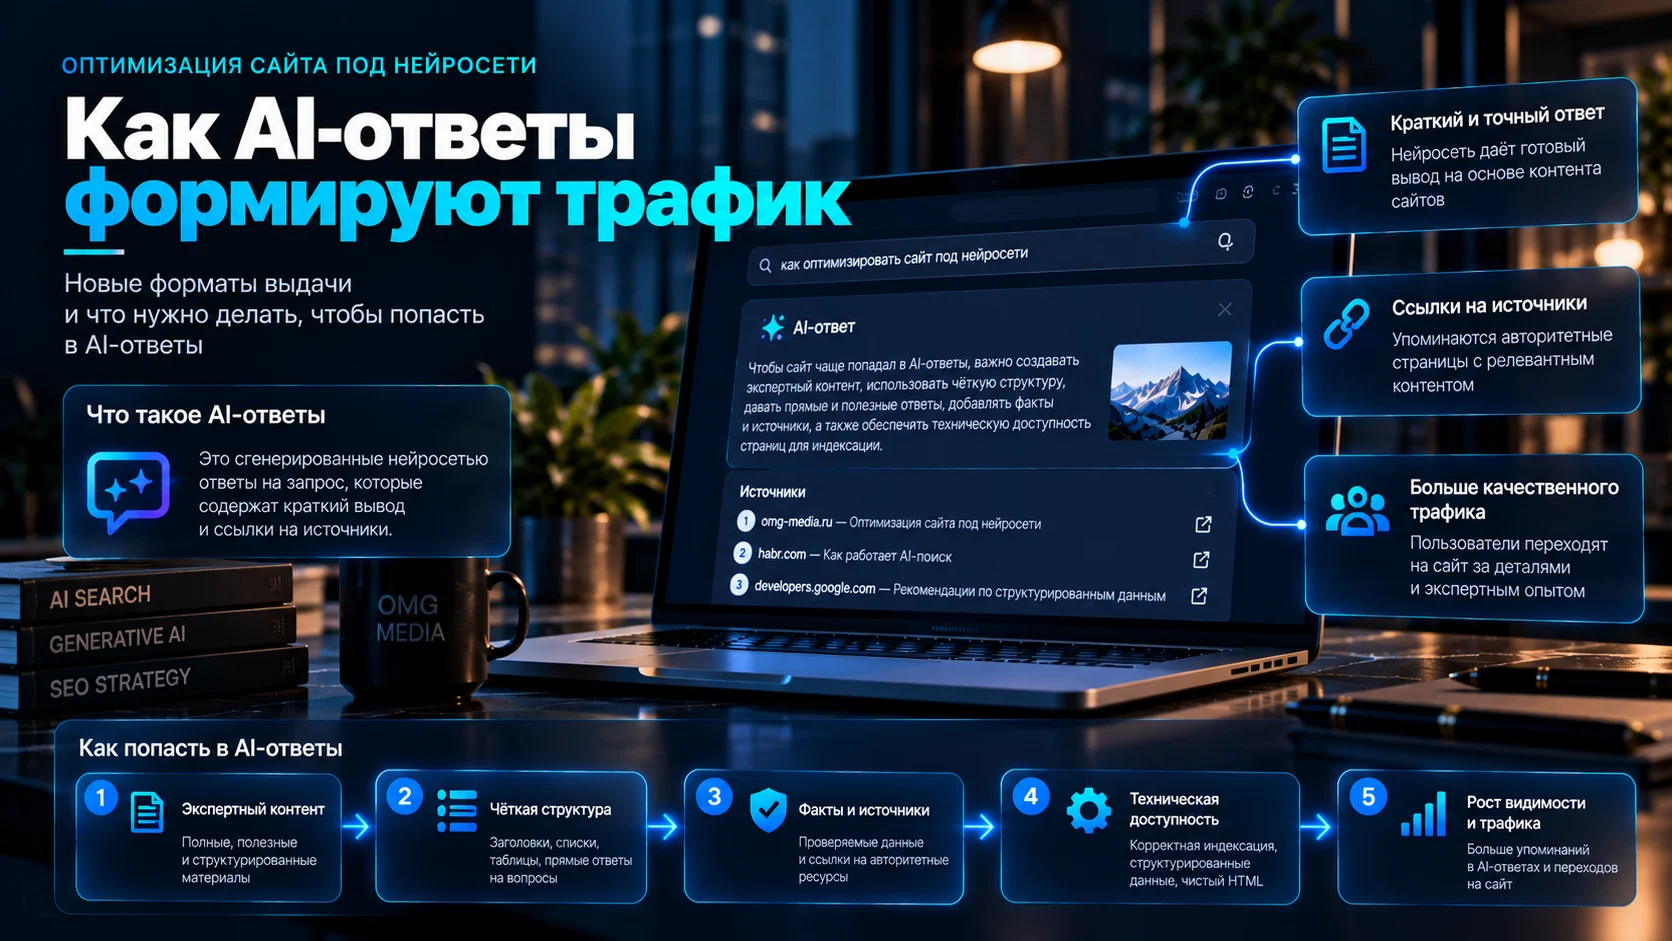
Отдельная статья не должна быть информационным островом. Внутренние ссылки помогают поисковым системам обнаруживать URL, а пользователю — переходить от объяснения к связанным материалам, услугам и доказательствам.
- Из статьи ведите на действительно связанный материал более широкого интента, а не на страницу с почти тем же ответом.
- Со страниц услуг ведите к руководствам, кейсам и методологиям, которые объясняют подход компании.
- Употребляйте название бренда, услуг и экспертов последовательно во всём сайте.
- Проверьте страницу «О компании», контакты, профили авторов, кейсы и реквизиты: противоречия между ними создают лишнюю неоднозначность.
- Не создавайте десятки почти одинаковых страниц под формулировки одного вопроса. Google в руководстве 2026 года отдельно предупреждает против массового производства страниц под вариации запросов и fan-out-запросы ради манипуляции выдачей.
9. Поддерживайте актуальность, а не только дату
AI-системы и поисковые функции быстро меняются, поэтому материал о доступности для AI нельзя считать «вечнозелёным» без редакционного процесса.
- Назначьте владельца материала и дату следующей проверки.
- Обновляйте факт и ссылку, когда меняется документация платформы.
- Меняйте
dateModifiedтолько после реального содержательного обновления. - Удаляйте устаревшие рекомендации, а не просто добавляйте новый абзац в конец.
- После технических изменений повторно проверяйте indexability, rendered HTML и журналы доступа.
- Для важных обновлений отправляйте актуальные сигналы обнаружения: sitemap и, где применимо, IndexNow.
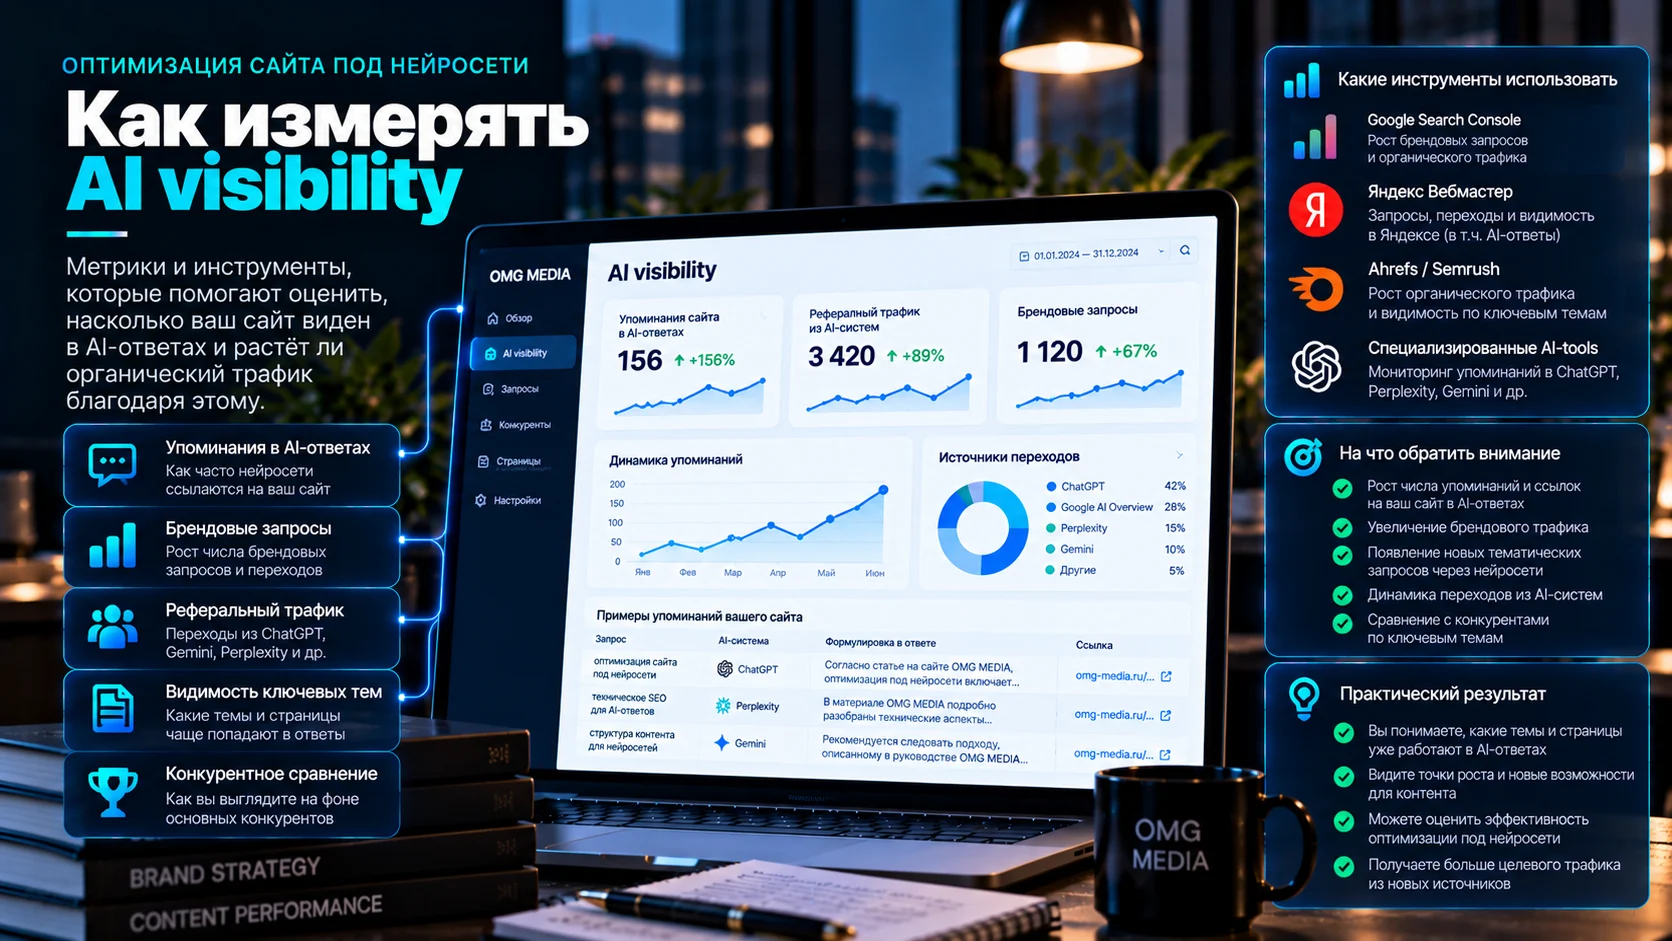
10. Измеряйте AI visibility без единого выдуманного «GEO-балла»
AI visibility нельзя свести к одному универсальному числу. Разные системы показывают разные ответы, наборы источников меняются, а некоторые платформы дают только агрегированную статистику. Нужна панель из нескольких наблюдений.
| Слой | Что измерять | Ограничение |
|---|---|---|
| показы, клики, страницы, запросы и конверсии из Search Console/аналитики | AI Overviews и AI Mode входят в общий тип Web в Search Console, отдельного полного AI-отчёта там нет | |
| Bing/Copilot | AI Performance: цитирования, страницы, grounding queries; в расширенном preview — Intents, Topics, Citation Share и сравнение периодов | Citation Share — наблюдательная метрика, а не рейтинг качества или доля трафика |
| Яндекс/Алиса AI | доля упоминаний среди источников, динамика, примеры запросов и тематическое окружение | данные инструмента собираются на ограниченном наборе запросов и не являются гарантией будущих показов |
| ChatGPT | реферальные переходы с utm_source=chatgpt.com, посадочные страницы, конверсии |
переходы показывают только случаи с кликом и не измеряют все упоминания бренда |
| Контрольная панель запросов | бренд упомянут или нет, есть ли ссылка, какой URL процитирован, какие конкуренты и источники рядом | ответы динамичны; единичный ручной запрос нельзя считать трендом |
Для контрольной панели зафиксируйте набор реальных вопросов клиентов и повторяйте замер на одинаковых формулировках и платформах. Смотрите не только факт упоминания, но и страницу-источник, тип ответа, дату и бизнес-результат. Так можно отличить разовый скриншот от устойчивой динамики.
Чек-лист: оптимизация сайта под нейросети
| Проверка | Как проверить | Критичный дефект | Статус |
|---|---|---|---|
| Crawlability ключевых URL | robots.txt, логи, тестовые запросы | нужный робот получает запрет/403/CAPTCHA | Да / Нет / Н/П |
| Разделены search и training-боты | сверить user-agent с первичной документацией | training-бот ошибочно считается обязательным для поиска | Да / Нет / Н/П |
| CDN/WAF не блокирует нужных роботов | логи, IP-проверка, правила firewall | robots разрешает, инфраструктура блокирует | Да / Нет / Н/П |
| HTTP-ответ ключевых страниц | crawler, URL inspection, серверные логи | 5xx, soft 404, нежелательные редиректы | Да / Нет / Н/П |
| Noindex | HTML и HTTP headers | важная страница закрыта от индекса | Да / Нет / Н/П |
| Snippet controls | robots meta, X-Robots-Tag, data-nosnippet | массовое ограничение нужного текста | Да / Нет / Н/П |
| Canonical | HTML, sitemap, выбранная поиском каноническая версия | canonical ведёт на другой/устаревший URL | Да / Нет / Н/П |
| Sitemap | состав и lastmod | неактуальные или неканонические URL | Да / Нет / Н/П |
| Рендеринг | исходный HTML и rendered DOM | основной смысл появляется только после действия пользователя | Да / Нет / Н/П |
| Краулируемые ссылки | проверить навигацию и DOM | ключевые переходы реализованы без обычного href | Да / Нет / Н/П |
| HTML-иерархия | title, H1, H2/H3, main/article/section | структура не отражает смысл документа | Да / Нет / Н/П |
| Текстовая доступность | отключить стили/часть JS и проверить DOM | важные факты существуют только в изображениях/виджетах | Да / Нет / Н/П |
| Одна основная тема URL | сверить title, H1, интент и содержание | страница смешивает несколько несвязанных задач | Да / Нет / Н/П |
| Прямой ответ | прочитать начало каждого ключевого раздела | вывод появляется только после длинной преамбулы | Да / Нет / Н/П |
| Самостоятельность блоков | прочитать раздел вне контекста | неясно, о каком объекте или условии идёт речь | Да / Нет / Н/П |
| Источники | проверить ссылки и происхождение фактов | изменчивые факты без первичного источника | Да / Нет / Н/П |
| Авторство | byline и страница автора | нет ответственного автора/редакции при экспертном материале | Да / Нет / Н/П |
| Доказательства | методология, кейсы, расчёты, исходные условия | маркетинговые обещания без проверяемой основы | Да / Нет / Н/П |
| Entity consistency | название бренда, люди, услуги, контакты | противоречия между страницами и разметкой | Да / Нет / Н/П |
| Schema | валидатор и сравнение с видимым текстом | разметка описывает то, чего нет на странице | Да / Нет / Н/П |
| Внутренние связи | crawler и ручная карта кластера | страница-сирота или конкурирующие URL одного интента | Да / Нет / Н/П |
| Актуальность | дата проверки, факты, ссылки, dateModified | устаревшая инструкция с искусственно свежей датой | Да / Нет / Н/П |
| Брендовый контур | «О компании», услуги, авторы, кейсы, контакты | непонятно, кто является источником и что именно предлагает бренд | Да / Нет / Н/П |
| AI visibility baseline | Search Console, Bing Webmaster Tools, Яндекс Вебмастер, аналитика, контрольные запросы | результат оценивается одним скриншотом или одной метрикой | Да / Нет / Н/П |
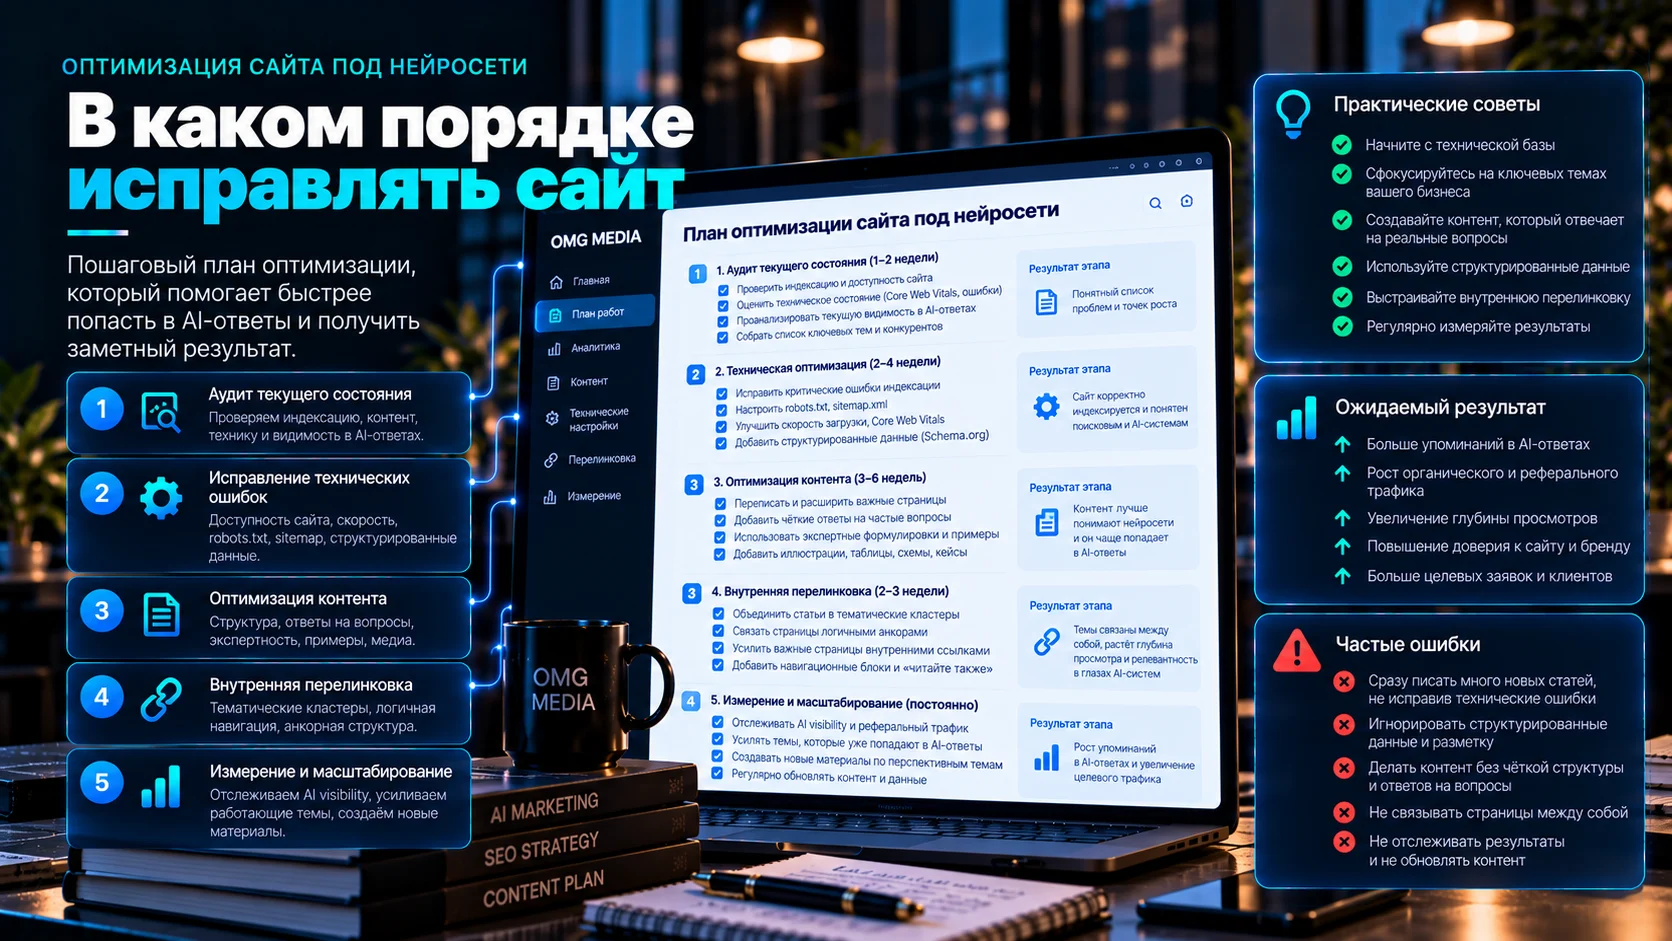
Приоритет исправлений
Если чек-лист дал много замечаний, исправляйте их в порядке зависимости. Сначала доступ и индексирование, затем рендеринг и HTML, после этого — сущности и структурированные данные, затем содержание, доказательства и внутренние связи. Измерение имеет смысл только после того, как базовые страницы технически пригодны для обнаружения и использования.
- Критический уровень: robots/WAF, 4xx/5xx, noindex, неверный canonical, недоступный основной контент.
- Высокий: пустой или нестабильный rendered HTML, дубли, страницы-сироты, противоречивые сущности, отсутствие самостоятельного ответа.
- Средний: слабые доказательства, неполное авторство, неаккуратная schema, устаревшие ссылки и данные.
- Наблюдение: AI visibility, набор цитируемых URL, типы запросов, упоминания бренда и конверсии.
Когда нужен отдельный AEO/GEO-аудит
Если проблема выходит за рамки одной страницы — например, неясно, какие URL должны быть источниками, поисковые и AI-системы выбирают конкурентов, бренд описан непоследовательно или нет системы измерения — нужен аудит всего контура. OMG MEDIA проводит AEO/GEO-аудит и продвижение в ИИ-поиске: проверяет техническую доступность, структуру ответов, сущности, доказательства, тематические связи и набор измеряемых запросов. Результат такой работы — приоритетный план изменений, а не обещание гарантированного цитирования конкретной нейросетью.
Частые вопросы
Можно ли заставить ChatGPT цитировать конкретную страницу?
Нет. Можно обеспечить доступ OAI-SearchBot, убрать инфраструктурные блокировки, улучшить релевантность, ясность и проверяемость страницы, но OpenAI не обещает верхнее размещение или обязательную цитату. Выбор источников зависит от запроса и работы поисковой системы.
Нужно ли открывать GPTBot ради ChatGPT Search?
Не обязательно. OpenAI разделяет OAI-SearchBot для поиска и GPTBot для возможного обучения моделей. Политику доступа к ним можно настраивать отдельно.
Нужен ли llms.txt?
Не рассматривайте его как обязательное условие видимости. Google прямо пишет, что для generative AI features в Search не нужны новые machine-readable AI-файлы. Отдельные сервисы могут использовать собственные форматы или публиковать llms.txt для навигации по документации, но это не универсальная замена robots.txt, sitemap, индексации и качественного HTML.
Какая schema лучше всего помогает цитированию?
Специальной «AI schema» нет. Используйте типы, которые правдиво описывают видимое содержание страницы и сущности: например, Article, Organization, Person, BreadcrumbList, Service или Product по ситуации. Валидная schema снижает неоднозначность, но не гарантирует цитирование.
Нужно ли переписывать весь JavaScript-сайт на SSR?
Нет универсального требования. Сначала проверьте, что поисковый робот получает и рендерит главный контент, ссылки и структурированные данные. Если клиентский рендеринг делает важный текст нестабильным или недоступным, SSR/SSG или пререндеринг могут быть разумным инженерным решением.
Первичные источники и дата проверки
Рекомендации в статье проверены 22 августа 2026 года по первичной документации платформ. Для технических решений сверяйтесь с актуальной версией документов, потому что user-agent, preview controls и отчёты AI visibility могут меняться.
- Google Search Central: Optimizing your website for generative AI features.
- Google Search Central: AI features and your website.
- Google Search Central: JavaScript SEO basics.
- Google Search Central: General structured data guidelines.
- Bing Webmaster Guidelines.
- Bing Webmaster Tools: AI Visibility Insights.
- OpenAI: Publishers and Developers FAQ.
- OpenAI: ChatGPT Search.
- Anthropic: crawler controls.
- Perplexity: crawlers.
- Яндекс Вебмастер: «Видимость сайта в Алисе AI».
- Яндекс Вебмастер: управление индексированием и ответами Алисы AI.


